Enterprise en datacenter
Recuperatie van zeer grote volumes
ZFS-pools, grote NAS- en SAN-volumes en bestandssystemen van honderden terabytes. Met eigen software die de recuperatie opsplitst in drie processen.
Herstel
Harde schijf en SSD HDD, SSD, externe schijven, flashkaarten RAID, NAS & SAN Alle niveaus, alle controllers, virtualisatie Smartphones en tablets iPhone, Android, iPad, Huawei Tapes LTO, DAT, DLT en oudere formaten
Toegang na aanmelden.
EN · RU · ZH · ES
Enterprise en datacenter
ZFS-pools, grote NAS- en SAN-volumes en bestandssystemen van honderden terabytes. Met eigen software die de recuperatie opsplitst in drie processen.
Een volume van honderden terabytes laat zich niet behandelen als een grote harde schijf. De gegevens zijn verspreid over tientallen schijven, het bestandssysteem houdt zijn structuur bij in bomen en verwijzingen die zelf over het hele volume verspreid staan, en bij copy-on-write-systemen zoals ZFS en Btrfs bestaan er vaak meerdere versies van dezelfde structuur naast elkaar.
Gewone recuperatiesoftware probeert zo'n volume in één keer te lezen en te begrijpen. Bij deze omvang loopt dat vast op tijd, geheugen of de hoeveelheid tussenresultaten.
Bestandssystemen en volumes die tot honderden terabytes groot worden, zoals:
Twijfelt u of uw systeem hieronder valt, neem dan contact op met de gegevens van uw opstelling.
Daarom hebben we eigen software ontwikkeld die de recuperatie opsplitst in drie opeenvolgende processen:
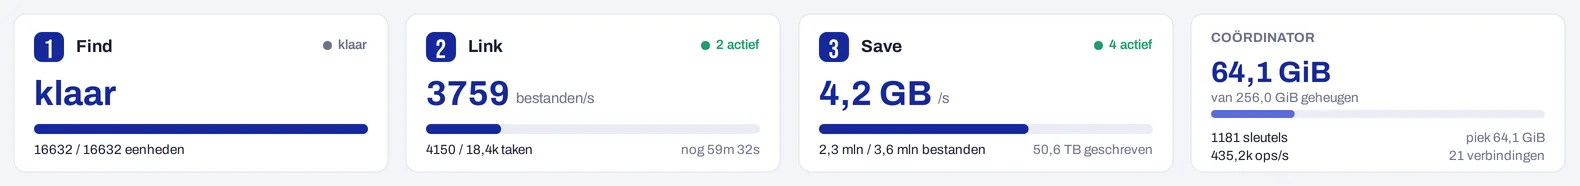
We doorzoeken het volume naar de bouwstenen van het bestandssysteem: nodes, fragmenten en snippets (nodes, fragments, snippets) van metadata en gegevens, waar ze ook staan.
De gevonden stukken worden in kaart gebracht, aan elkaar geschakeld, samengevoegd en gesorteerd (mapping, chaining, stitching, sorting), tot de structuur van mappen en bestanden weer klopt.
De gereconstrueerde bestanden worden geconsolideerd en overgezet naar de doelopslag (consolidate, transfer).
Waarom zo: door de recuperatie op te splitsen in drie processen, hoeft geen enkel proces het hele volume in één keer te bevatten, en levert elk proces een eigen resultaat op waarmee het volgende verder werkt.
De drie processen draaien in onze eigen software, Three-Tier Recovery. Een coördinator (coordinator) verdeelt het werk en houdt de gevonden sleutels bij in het geheugen; de eigenlijke verwerking gebeurt door workers, per proces: Find-workers scannen het volume, Link-workers koppelen de stukken aan elkaar, Save-workers schrijven de bestanden weg.
Een monitor toont het verloop van een dossier op elk moment:
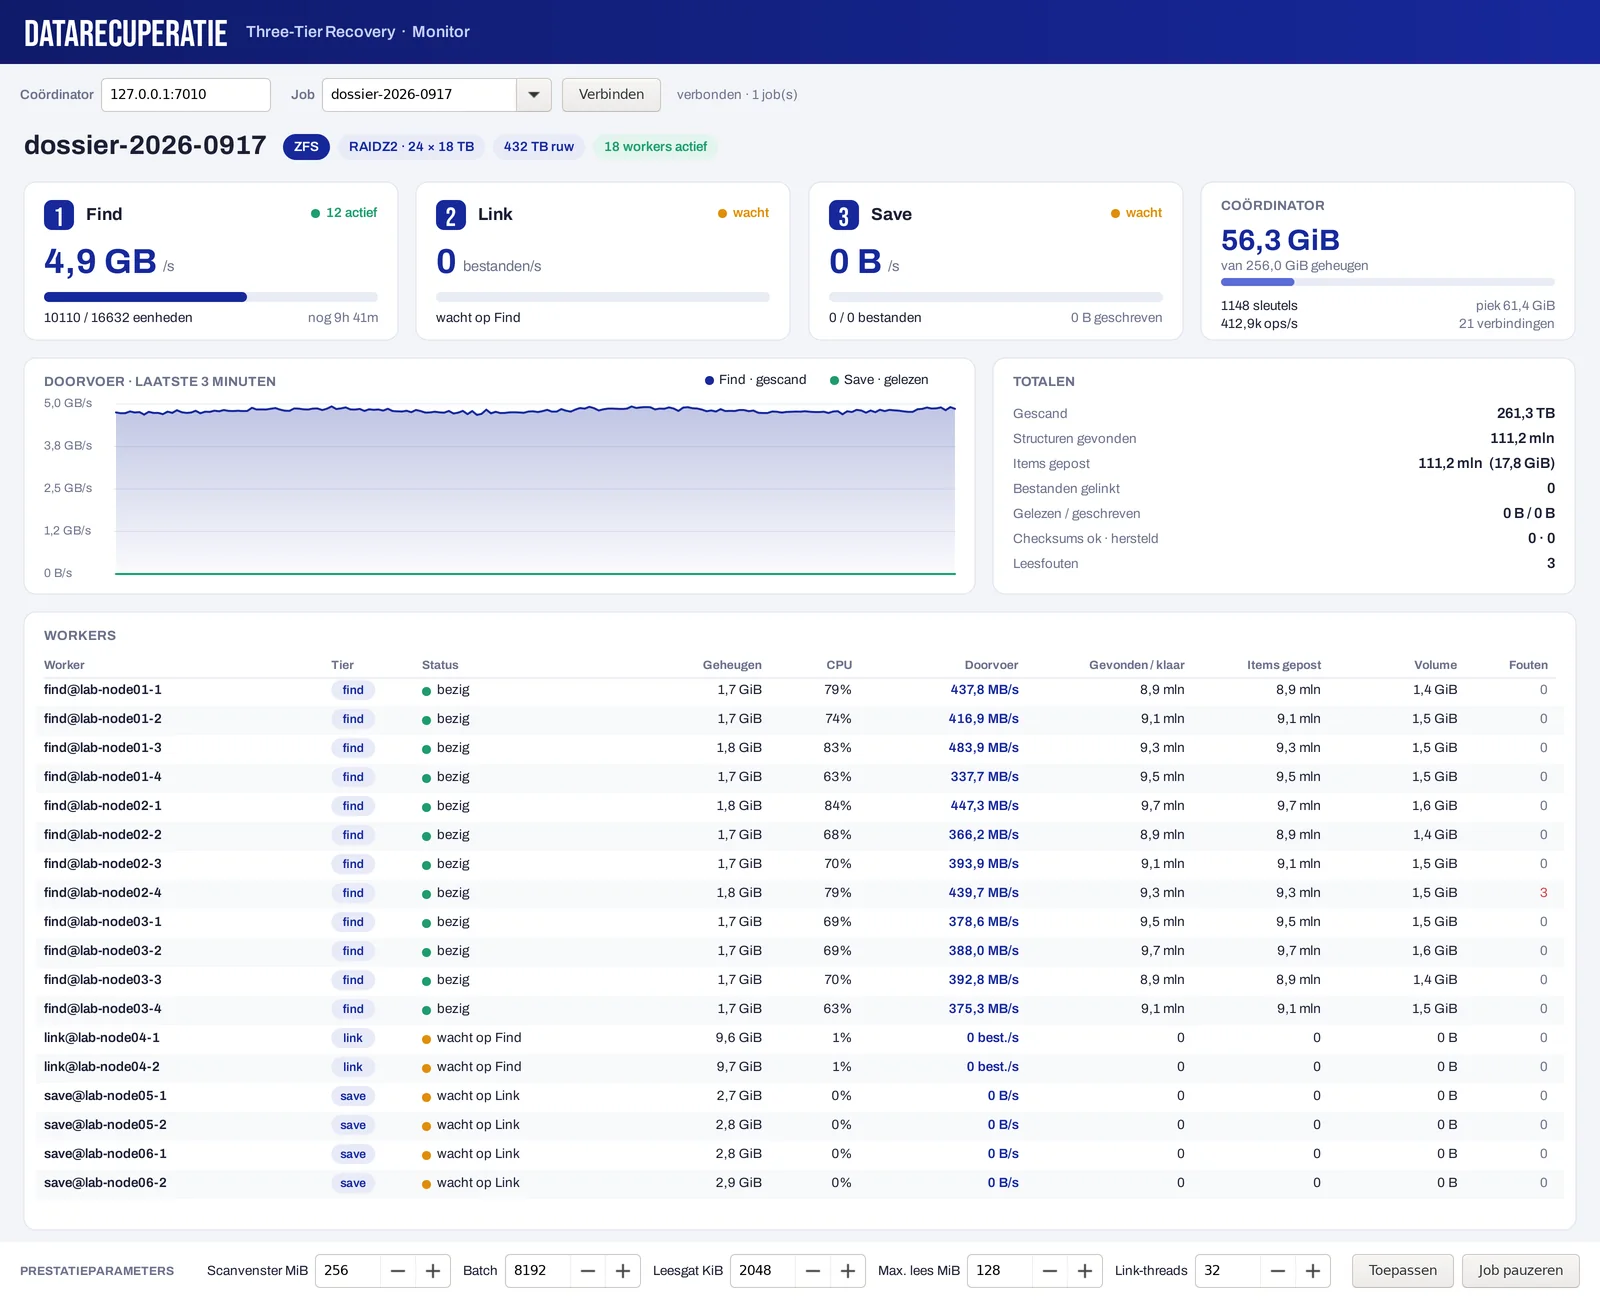
Prestatieparameters zoals het scanvenster (scan window), de batchgrootte, de maximale leesgrootte en het aantal threads voor het koppelen kunnen tijdens een lopende job aangepast worden, en een job kan gepauzeerd worden. Zo stemmen we de belasting af op de toestand van de schijven en de beschikbare machines.
Bij bestandssystemen met checksums, zoals ZFS, controleert de software de checksums van de gelezen gegevens, en houdt ze bij hoeveel blokken in orde waren en hoeveel hersteld werden.
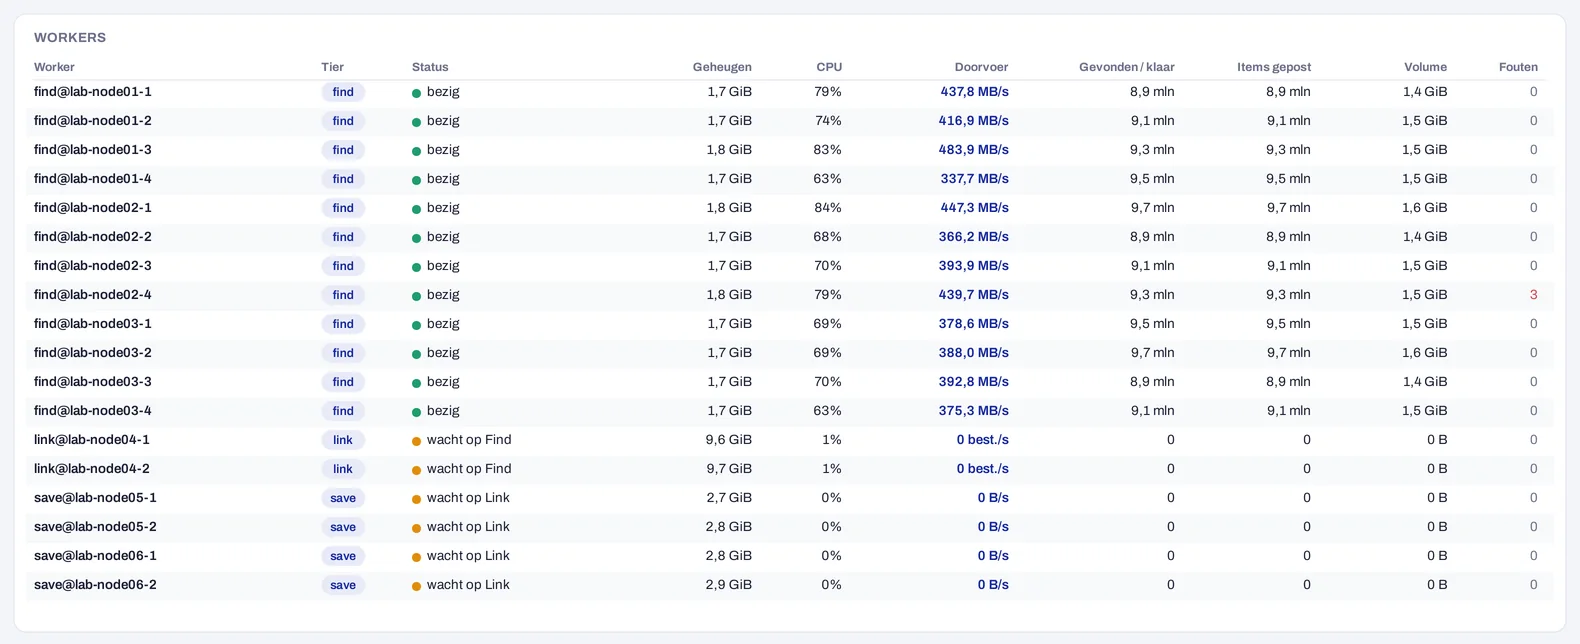
De workers hoeven niet op één machine te draaien. Het scannen wordt verdeeld over meerdere nodes, die elk een deel van het volume verwerken. Voor een volume van honderden terabytes zetten we zoveel workers in als het dossier vraagt, en volgen we ze afzonderlijk op.
ZFS schrijft nooit over bestaande gegevens heen (copy-on-write), maar schrijft nieuwe versies weg en verwijst daarnaar vanuit een boom van blokverwijzingen. Bovenaan staat telkens de meest recente toestand van de pool. Raakt die beschadigd, bijvoorbeeld door een defecte schijf, een fout bij het importeren of een stroomonderbreking, dan weigert de pool vaak te importeren, terwijl de gegevens zelf er nog staan.
Omdat ZFS oudere versies van zijn structuur niet meteen overschrijft, kan een recuperatie vaak terugvallen op een eerdere, consistente toestand. Dat is precies het soort zoekwerk waarvoor het eerste proces dient.
Elke schijf in een ZFS-pool heeft vier labels: twee aan het begin en twee aan het einde. Elk label bevat een ring van uberblocks, en elke uberblock verwijst naar de toestand van de pool na een transactiegroep (transaction group, TXG). De actieve toestand is de geldige uberblock met het hoogste TXG-nummer.
Omdat ZFS met copy-on-write werkt, blijven de blokken waarnaar oudere uberblocks verwijzen vaak nog een tijd onaangeroerd. Een oudere, consistente TXG kan zo het vertrekpunt van de reconstructie worden.
Iets anders dan de drie processen, maar vaak in hetzelfde dossier: opstellingen waarin gegevens in meerdere lagen boven elkaar liggen. Bijvoorbeeld:
Is één van die lagen beschadigd, dan gebruiken we de informatie uit de andere lagen om ze te reconstrueren. Zo verraadt het bestandssysteem binnen een partitie waar die partitie begon en eindigde, helpt de structuur binnen een virtuele schijf om haar fragmenten in de juiste volgorde te leggen, en maakt de interne opbouw van een databank het mogelijk om losse stukken weer aan elkaar te zetten.
Alles over meerlaagse recuperatie →
Partitionering: GPT bewaart een reservekopie van de header en de partitietabel aan het einde van de schijf. En zelfs zonder partitietabel verraadt de bootsector of het superblock van een bestandssysteem waar een partitie begint.
Deduplicatie (deduplication): de gegevens staan als unieke blokken (chunks) in een opslag, met een index die bepaalt welke blokken samen een bestand vormen. Is die index beschadigd, dan helpt de structuur van de laag erboven, zoals een virtuele schijf of een bestandssysteem, om de blokken opnieuw te ordenen.
Applicatiebestanden: een Exchange-databank (ESE) bestaat uit pagina's van vaste grootte, elk met een eigen controlesom (checksum). Dat helpt om ze tussen andere gegevens te herkennen.
Mogen de gegevens het gebouw niet verlaten, dan kan de recuperatie ook bij u ter plaatse, met onze mobiele cleanroom-kast.
Bel ons of vraag een analyse aan, met de opbouw van uw systeem en wat er gebeurde. We bekijken samen met u de beste aanpak.